中文查不准
CLIP 的文本塔只训练过英文,中文查询的召回明显变差。
解决:加一层查询改写,只把视觉描述翻成英文交给检索,原问留给生成。
COVER STORY多模态检索 · AI 工程
让图文检索
给出能核对的答案。
多模态 RAG 图像知识库
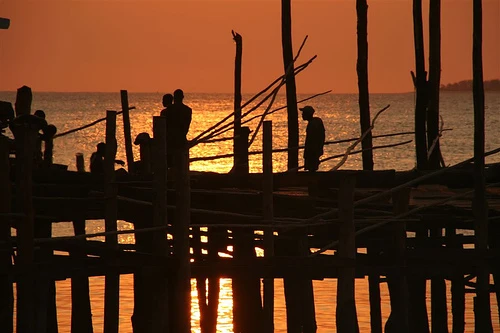
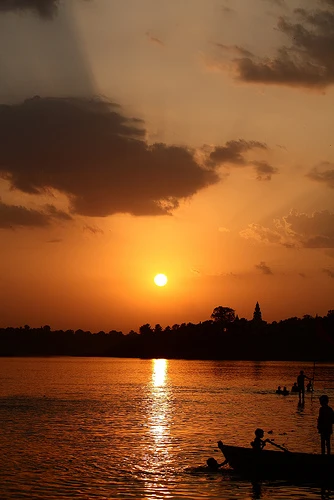
Flickr30K · 52446935.jpg · 日落问答召回图
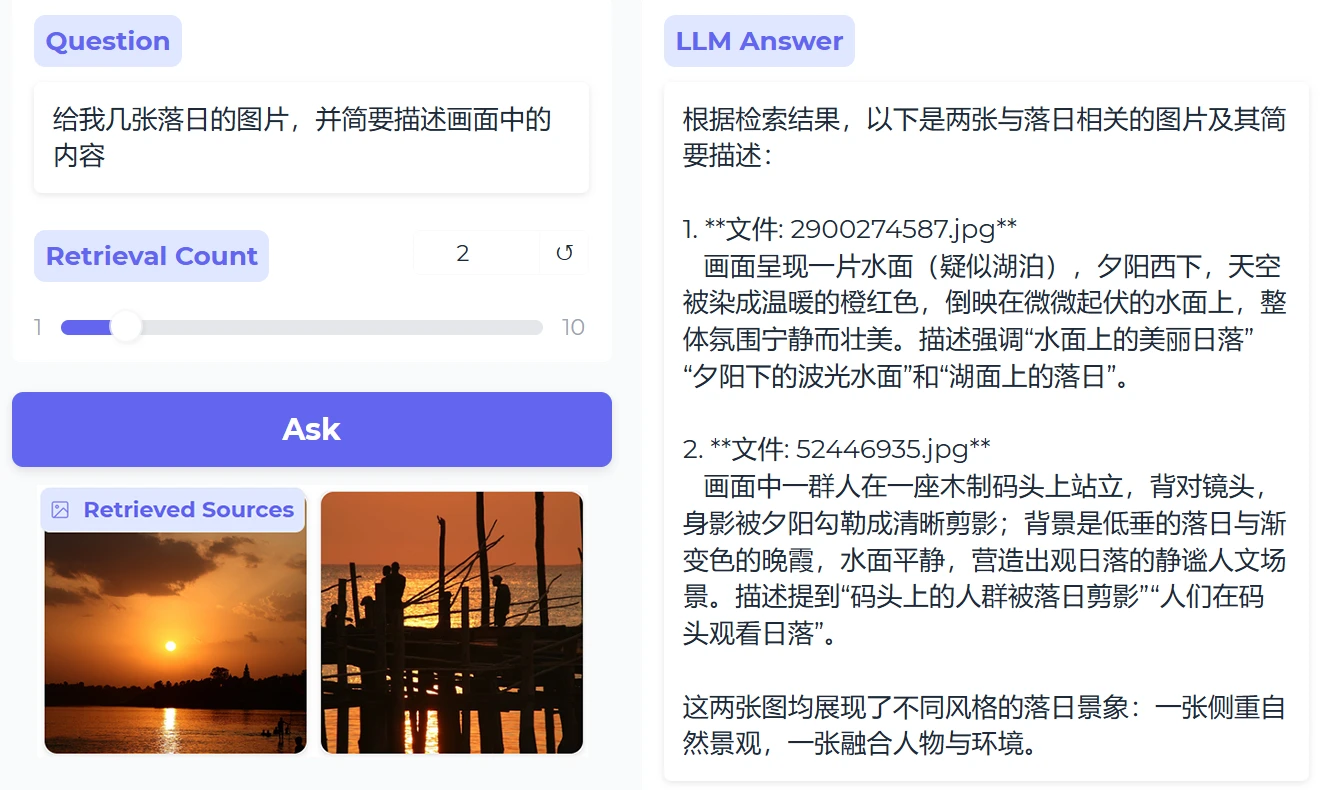
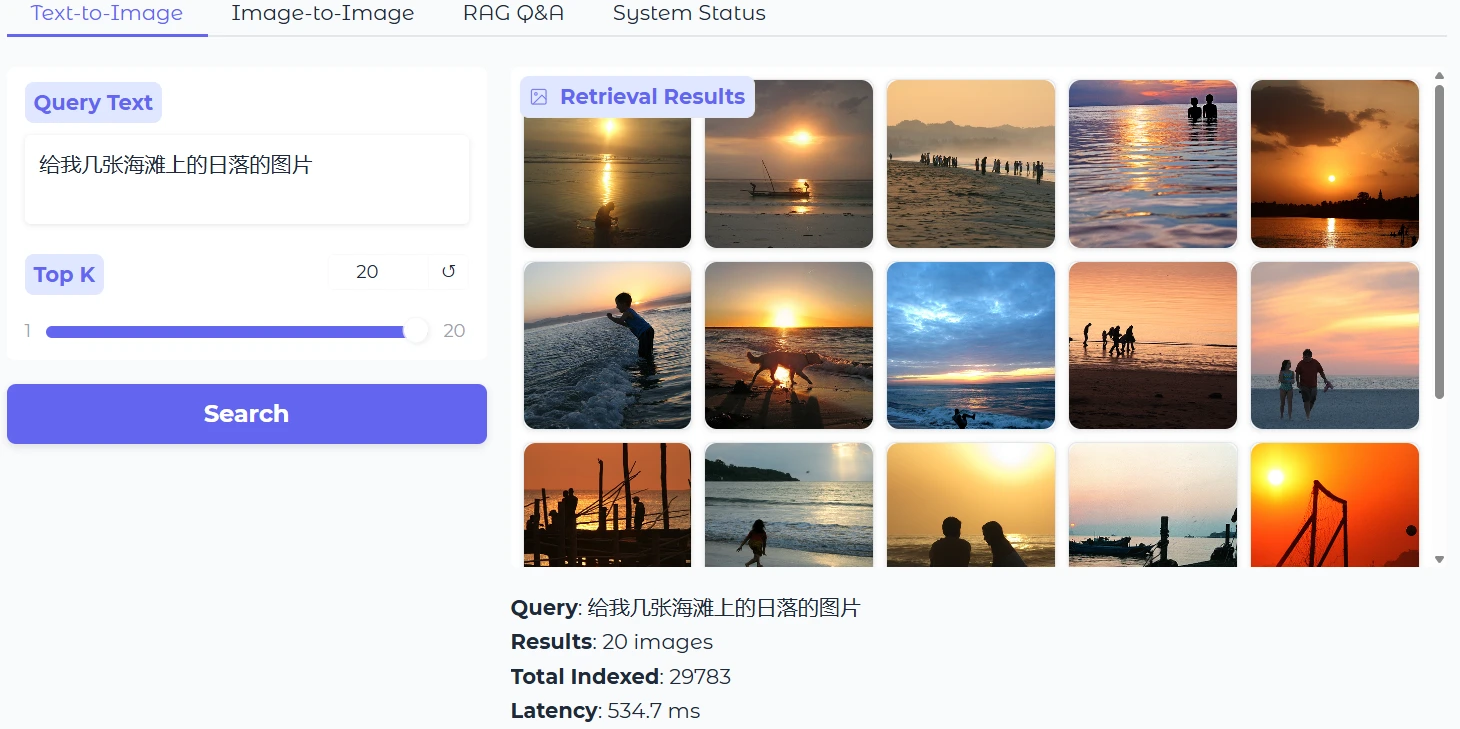
系统要回答「给我几张落日的图片,并描述画面」这样的问题。我把理解查询、检索图像、生成回答拆成三段,让回答里的每一张图都能查回文件名与图注。
演示里的中文原问,召回数量设为 2。CLIP 的文本编码器只懂英文,直接编码中文会丢掉大半语义。
改写层提取「落日」这类视觉目标,转成 CLIP 能编码的英文描述。生成回答时仍使用中文原问,语气和要求不会在翻译里走样。
图库在入库时一次性编码。查询只需编码一句英文,所以多语言能力不必重训编码器,现有 CLIP 与索引可以原样沿用。
一张是湖面上的落日倒影,一张是码头上看日落的人群剪影。检索侧合计约 45 ms。
SQLite 按向量编号查回文件名与图注,一起交给生成器。回答里每张图都能点回原图核对。
这是模型原答的节选,后面附着 52446935.jpg。分段计时显示,整条问答约 8.9 s 里绝大部分花在生成上,下一步优化先从这一段做起。
CLIP 的文本塔只训练过英文,中文查询的召回明显变差。
解决:加一层查询改写,只把视觉描述翻成英文交给检索,原问留给生成。
模型描述的画面和召回的图对不上时,用户无从判断。
解决:文件名与图注随检索结果进入提示词,回答必须指回具体图片。
一次问答近十秒,凭感觉很难说清是检索慢还是生成慢。
解决:按阶段分段计时,三轮复测确认检索约 45 ms,瓶颈在生成。
资料来自 ICME 2026 Demo 海报、Gradio 演示留档和 2026 年 4 月三轮复测。照片来自 Flickr30K。项目仓库 ↗
在全球校园人工智能算法精英大赛的像素级分割赛题里,我以 LEDNet 为起点设计轻量模型 self_net,在三类缺陷上与 31 M 参数的 UNet 对比。
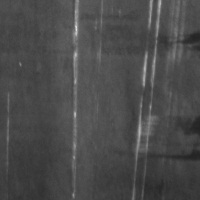
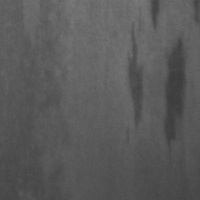
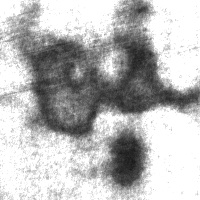
拖动样张上的竖线,对照原图与真实标注。200 × 200 px,同一坐标。
NEU-Seg · 840 张测试图。self_net 用 8 路测试时增强,UNet 为常规测试。
最深特征图停在原图的 1/8,用较浅的下采样保住细节,再用空洞卷积补回感受野。
分解卷积和注意力头入口降维,把模型控制在 0.78 M 参数。
CE + Dice + Lovász 组合损失,配合 EMA 与测试时增强。细长划痕仍是下一个改进点。
QUICK TOUR · 快速导览
你最想先了解哪方面的工作?
一个只在本机运行的网页。普通会话可以直接聊;复杂任务交给「中控」:它先和我确认目标草案,再派执行者去做,由独立验收判断是否达标,不达标就安排返工。
Windows 与 Linux 共用一份源码,运行数据按系统分开。Python 后端经 WebSocket JSON-RPC 驱动 Codex 会话,网页用 SSE 实时显示进度。
Exploded view · 拆解
每个任务都写明在等什么、执行者在做什么、下一步谁来处理。
№ 01业务流程、源码和检查互相关联;CI 跑相关回归与依赖规则。
№ 02只监听 127.0.0.1,不做公网入口;两系统数据分开存放。
№ 03AI 主持的中文互动叙事。单人可以自己探索;多人版先收齐同桌每个人的行动,再由房主推进一轮。主持要分清谁同意移动、谁还在准备,以及上一轮留下了什么。
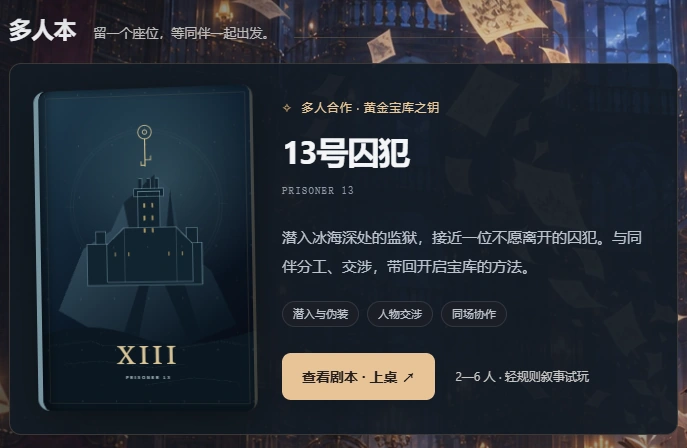
Playthrough · 模拟留档《13号囚犯》第 2 轮
第 1 轮结束,青禾、墨川和阿铃都在码头。下一轮的声明要逐人确认,是否加入替班厨工的队伍。
STATE · ROUND 1等待时留意补给怎样清点、厨工接受检查时通常要出示什么。
DECLARATION学着前面的厨工搬一件自己拿得动的补给;遇到核验便报本名,老实配合。
DECLARATION「队伍穿过六边形走廊,抵达热气与食物香味交织的厨房。阿铃把一路搬来的补给完整放下。」
HOST · RESOLVED第 3 轮开始时三人仍在厨房,各自分工。位置被正确延续,冒险还没结束。
STATE · ROUND 3三名虚构测试角色由模型扮演。原作为 WotC《Keys from the Golden Vault》中的《Prisoner 13》,此处是中文非官方轻规则改编。
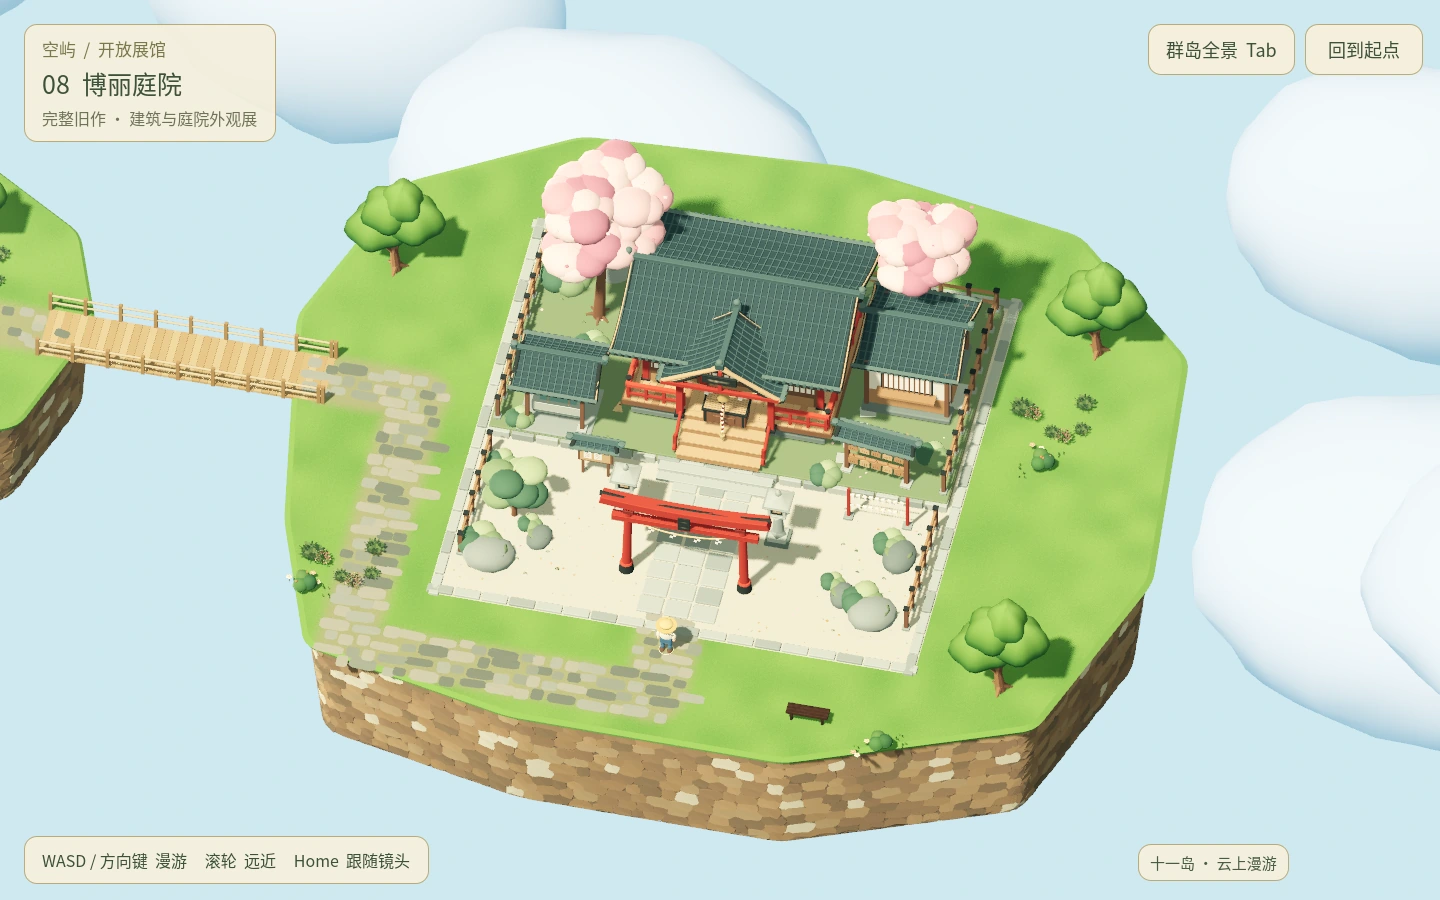
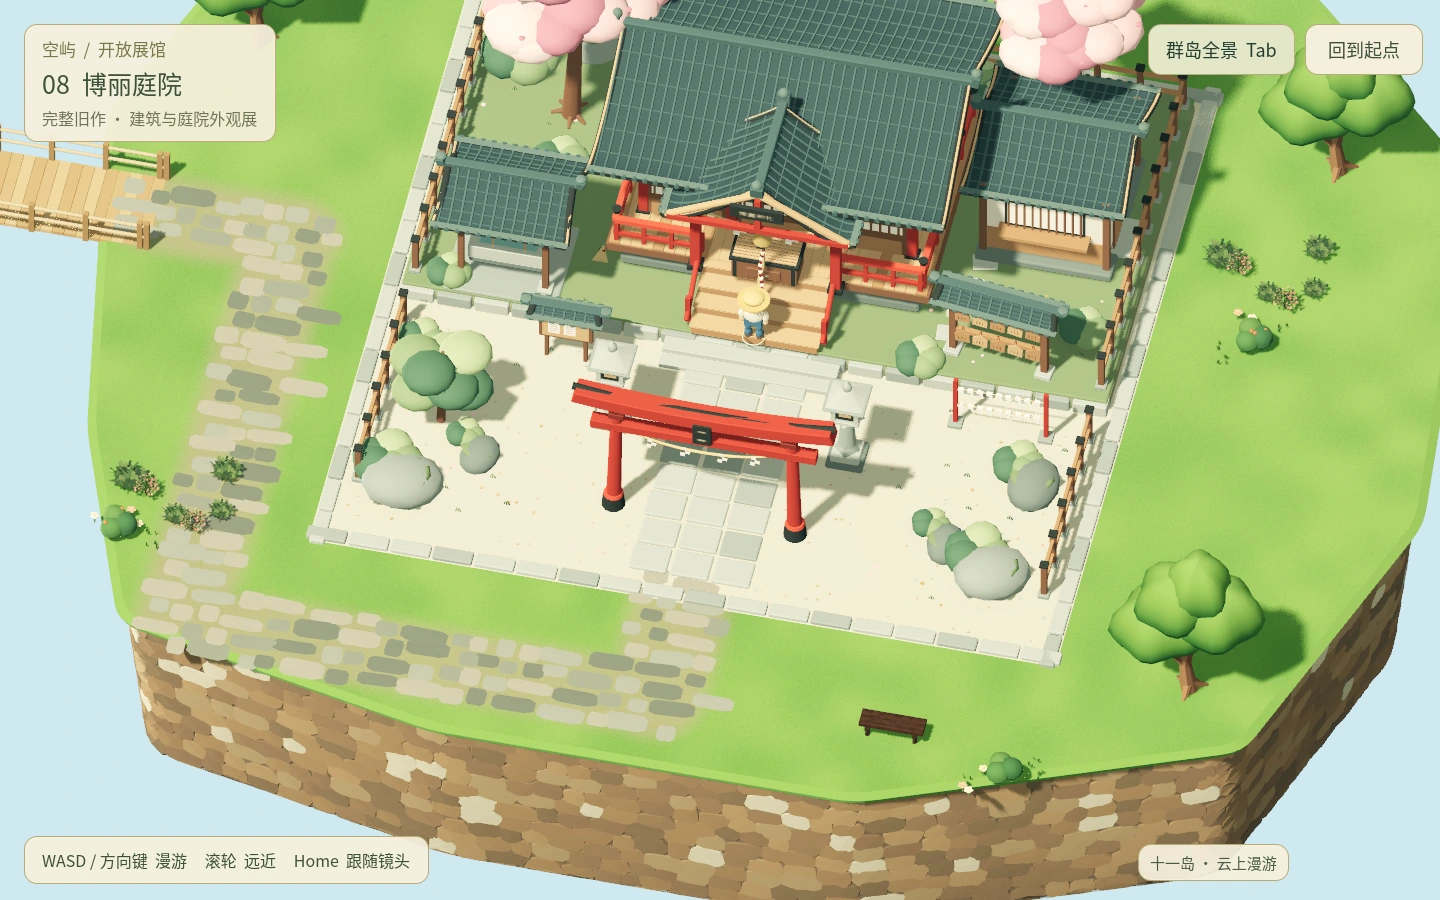
把旧作的杂货铺、茶楼、摊棚和神社编进浮空的岛屿。
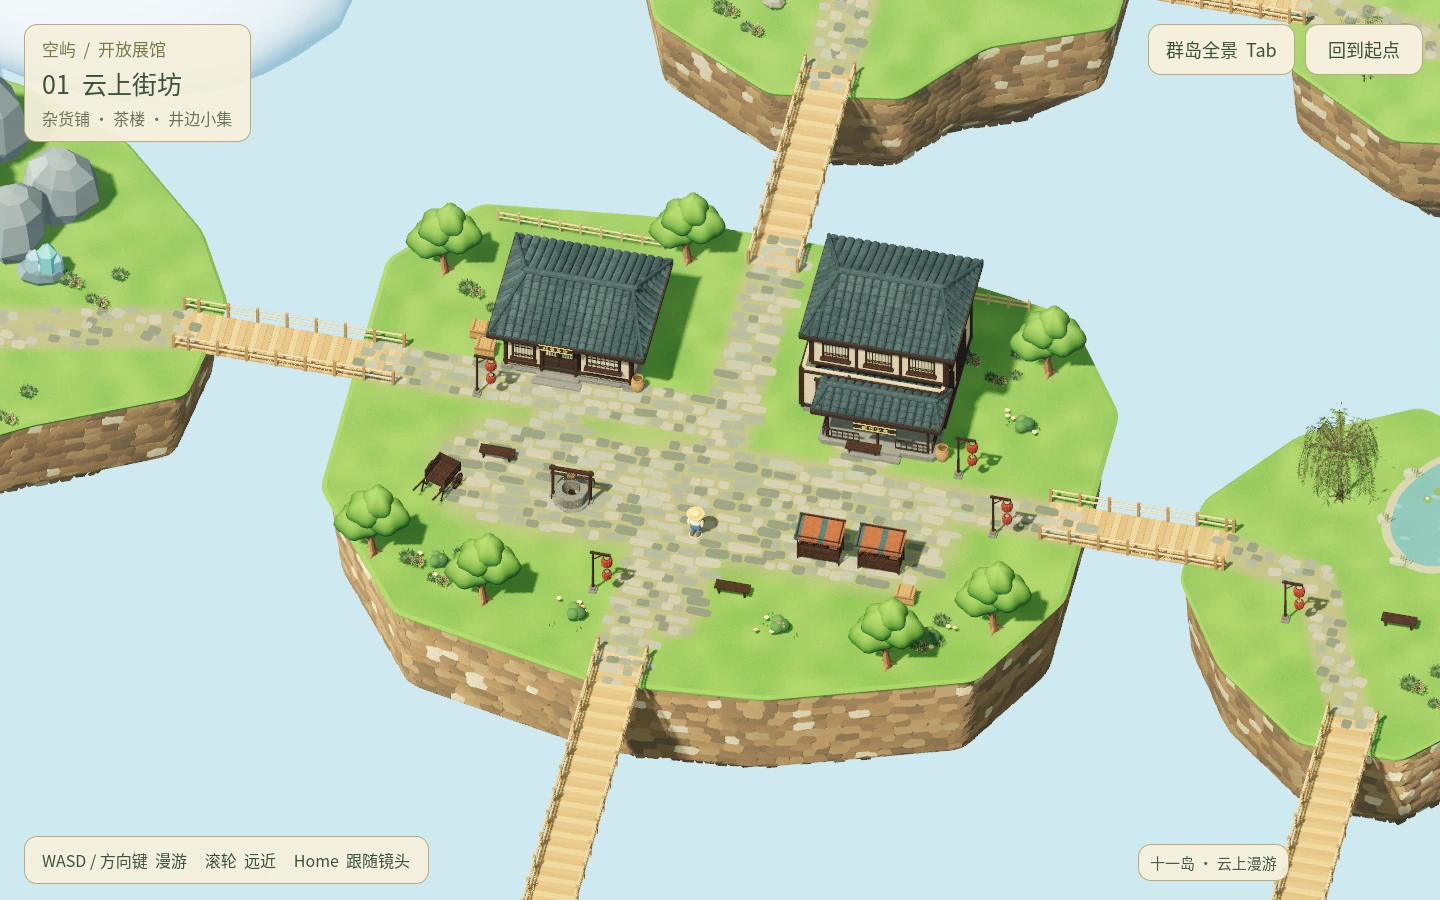
Field note
东方 Project 同人题材。建筑、配景和阶梯都放进同一个 Godot 展示馆,可以用 WASD 走进去看。点开任一张可以换到原尺寸核对细节。
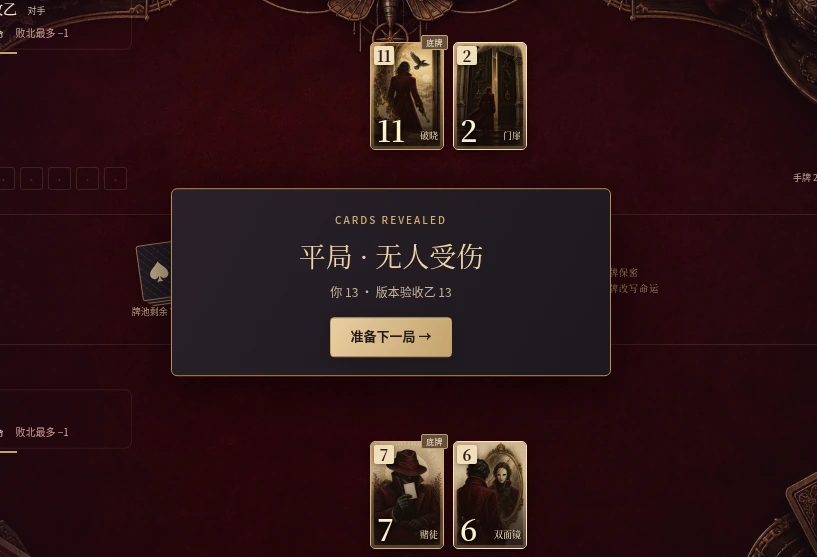
在 21 点里加入王牌。要牌还是停牌,什么时候打出王牌,让点数贴近 21 又不爆。可单人挑战 AI 希儿,也能双人联机;联机服务跑在我自己维护的 VPS 上。
上桌试玩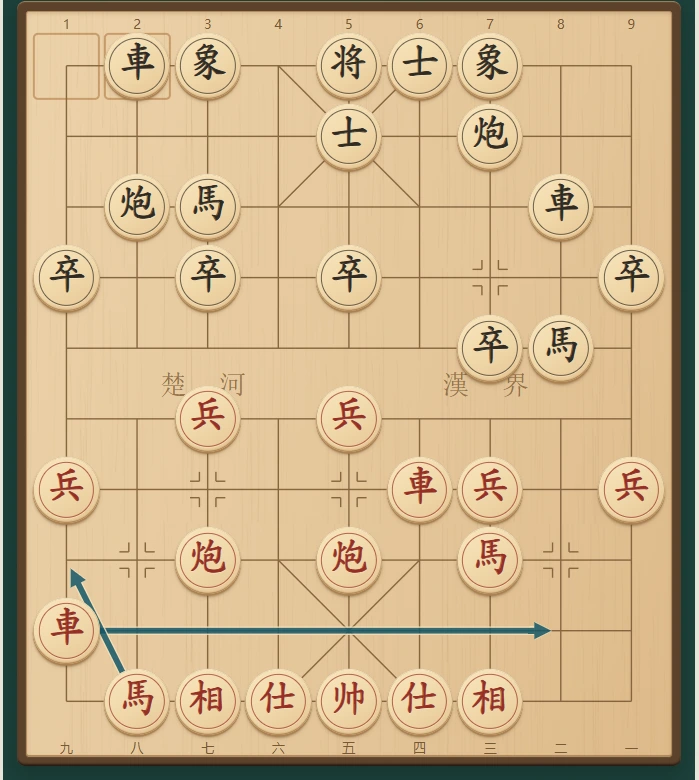
自己执红黑双方,按规则走子。开局资料和候选走法用箭头画在当前局面上,想清楚再落子。
我叫曹锐,在江南大学读完计算机科学与技术本科(2018–2022)和硕士(2023–2026)。研究方向是图文跨模态检索,关注噪声图文对和联邦检索里的错配。
Dual-Dimensional Attention Network for Image-Text Retrieval
空间与特征两个维度的注意力,配合差异化集合匹配,生成更有区分度、也更多样的跨模态表示。
Universal Feature Generation and Filling
用可学习的通用特征作稳定的语义锚,替换噪声对里不可靠的文本特征,从机制上避开误差累积。
Local Pair Repair for Noisy Correspondences
首次系统研究联邦跨模态检索中的噪声对应:不依赖公共数据,在客户端本地识别并修复错配。